AgentCore 에이전트의 응답 속도와 사용성을 어떻게 함께 개선할까
그래프가 화면에 나타났는데 에이전트는 계속 생각하고 있다. 긴 분석은 서버에서 끝났지만 로그인 갱신 뒤 진행 카드가 멈춘다. 같은 질문을 다시 입력하자 결과를 처음부터 계산한다. 사용자는 이 세 상황을 모두 느리다고 받아들인다. 원인은 서로 다르다.
우리가 데이터 분석 에이전트를 개선하면서 확인한 문제도 그랬다. 모델 추론 뒤의 불필요한 호출, 원본 수집과 중간 결과 복원, 화면의 상태 조회를 각각 살펴봐야 했다. Amazon Bedrock AgentCore는 에이전트 실행과 세션, 메모리와 관측 기능을 제공하지만 요청 완료와 업무 상태의 의미는 애플리케이션이 정한다.1
이 글의 구현 사례는 실제 코드와 2026년 10월 13일 운영 재측정 기록에서 가져왔다. 연구 문서의 작성·검증·승인 흐름은 별도 제안서와 상세 구현명세서를 일반화한 설계 예제다. 이 설계의 운영 성과는 아직 검증하지 않았다. 고객 식별 정보와 내부 주소를 제외하고 두 사례에서 재사용할 원칙을 설명한다.2
먼저 응답 속도와 업무 완료를 따로 측정한다
최초 토큰이 빨리 도착해도 답변이 완성되지 않으면 사용자는 기다린다. 반대로 작업에 시간이 걸리더라도 접수 여부와 진행 상황, 다시 열 수 있는 결과가 분명하면 사용자는 다른 일을 이어간다. 성능 지표를 하나로 묶으면 이 차이를 놓친다.
| 측정 구간 | 확인할 질문 | 개선할 대상 |
|---|---|---|
| 요청 → 접수·첫 응답 | 요청을 받았다는 사실을 언제 알 수 있는가 | 인증, 의도 해석, 초기 모델 호출 |
| 요청 → 필요한 산출물 | 표·그래프·근거가 언제 준비되는가 | 도구 실행, 계산, 검색, 파일 생성 |
| 요청 → 전체 완료 | 요청한 모든 항목이 끝났는가 | 복합 요청, 최종 검증, 불필요한 후속 추론 |
| 저장 완료 → 화면 표시 | 서버 결과를 사용자가 언제 확인하는가 | 상태 조회, 인증 갱신, 대화 복원 |
| 중단 → 복구 | 다시 접속하면 어디서 이어지는가 | 작업 상태, 체크포인트, 결과 소유권 |
우리 구현은 원본 다운로드, 압축 해제, DB 실행, 표본 변환, 체크포인트 읽기와 저장을 별도로 계측했다. 이 계측으로 병목을 확인하고 최적화 대상을 정했다. 세부 시간은 부모 구간에 포함되며 병렬 호출의 누적 시간과 벽시계 시간도 다르다. 항목을 모두 더해 전체 시간을 계산하면 안 된다.
AgentCore Observability는 모델·도구·에이전트의 실행을 추적하는 기반이다.3 애플리케이션에서는 요청 ID, 작업 ID, 단계, 실행 결과, 적용 버전을 연결한다. 세션 ID 하나만으로 여러 질문을 구분하지 않는다. 운영 로그에는 이 상관관계를 남기되 원본 질문·식별자·결과 데이터를 무조건 기록하지 않는다.
빠른 경로는 요청한 작업을 모두 확인한 뒤 종료한다
조회와 그래프 생성을 전용 도구로 처리하면 범용 에이전트의 탐색을 줄일 수 있다. 다만 빠른 경로가 질문의 일부만 처리하고 전체 답변을 끝내는 문제가 생기기 쉽다. “지난달 수치를 비교하고 그래프 두 개와 내부 기준을 함께 보여줘”라는 요청은 숫자 하나를 반환했다고 완료되지 않는다.
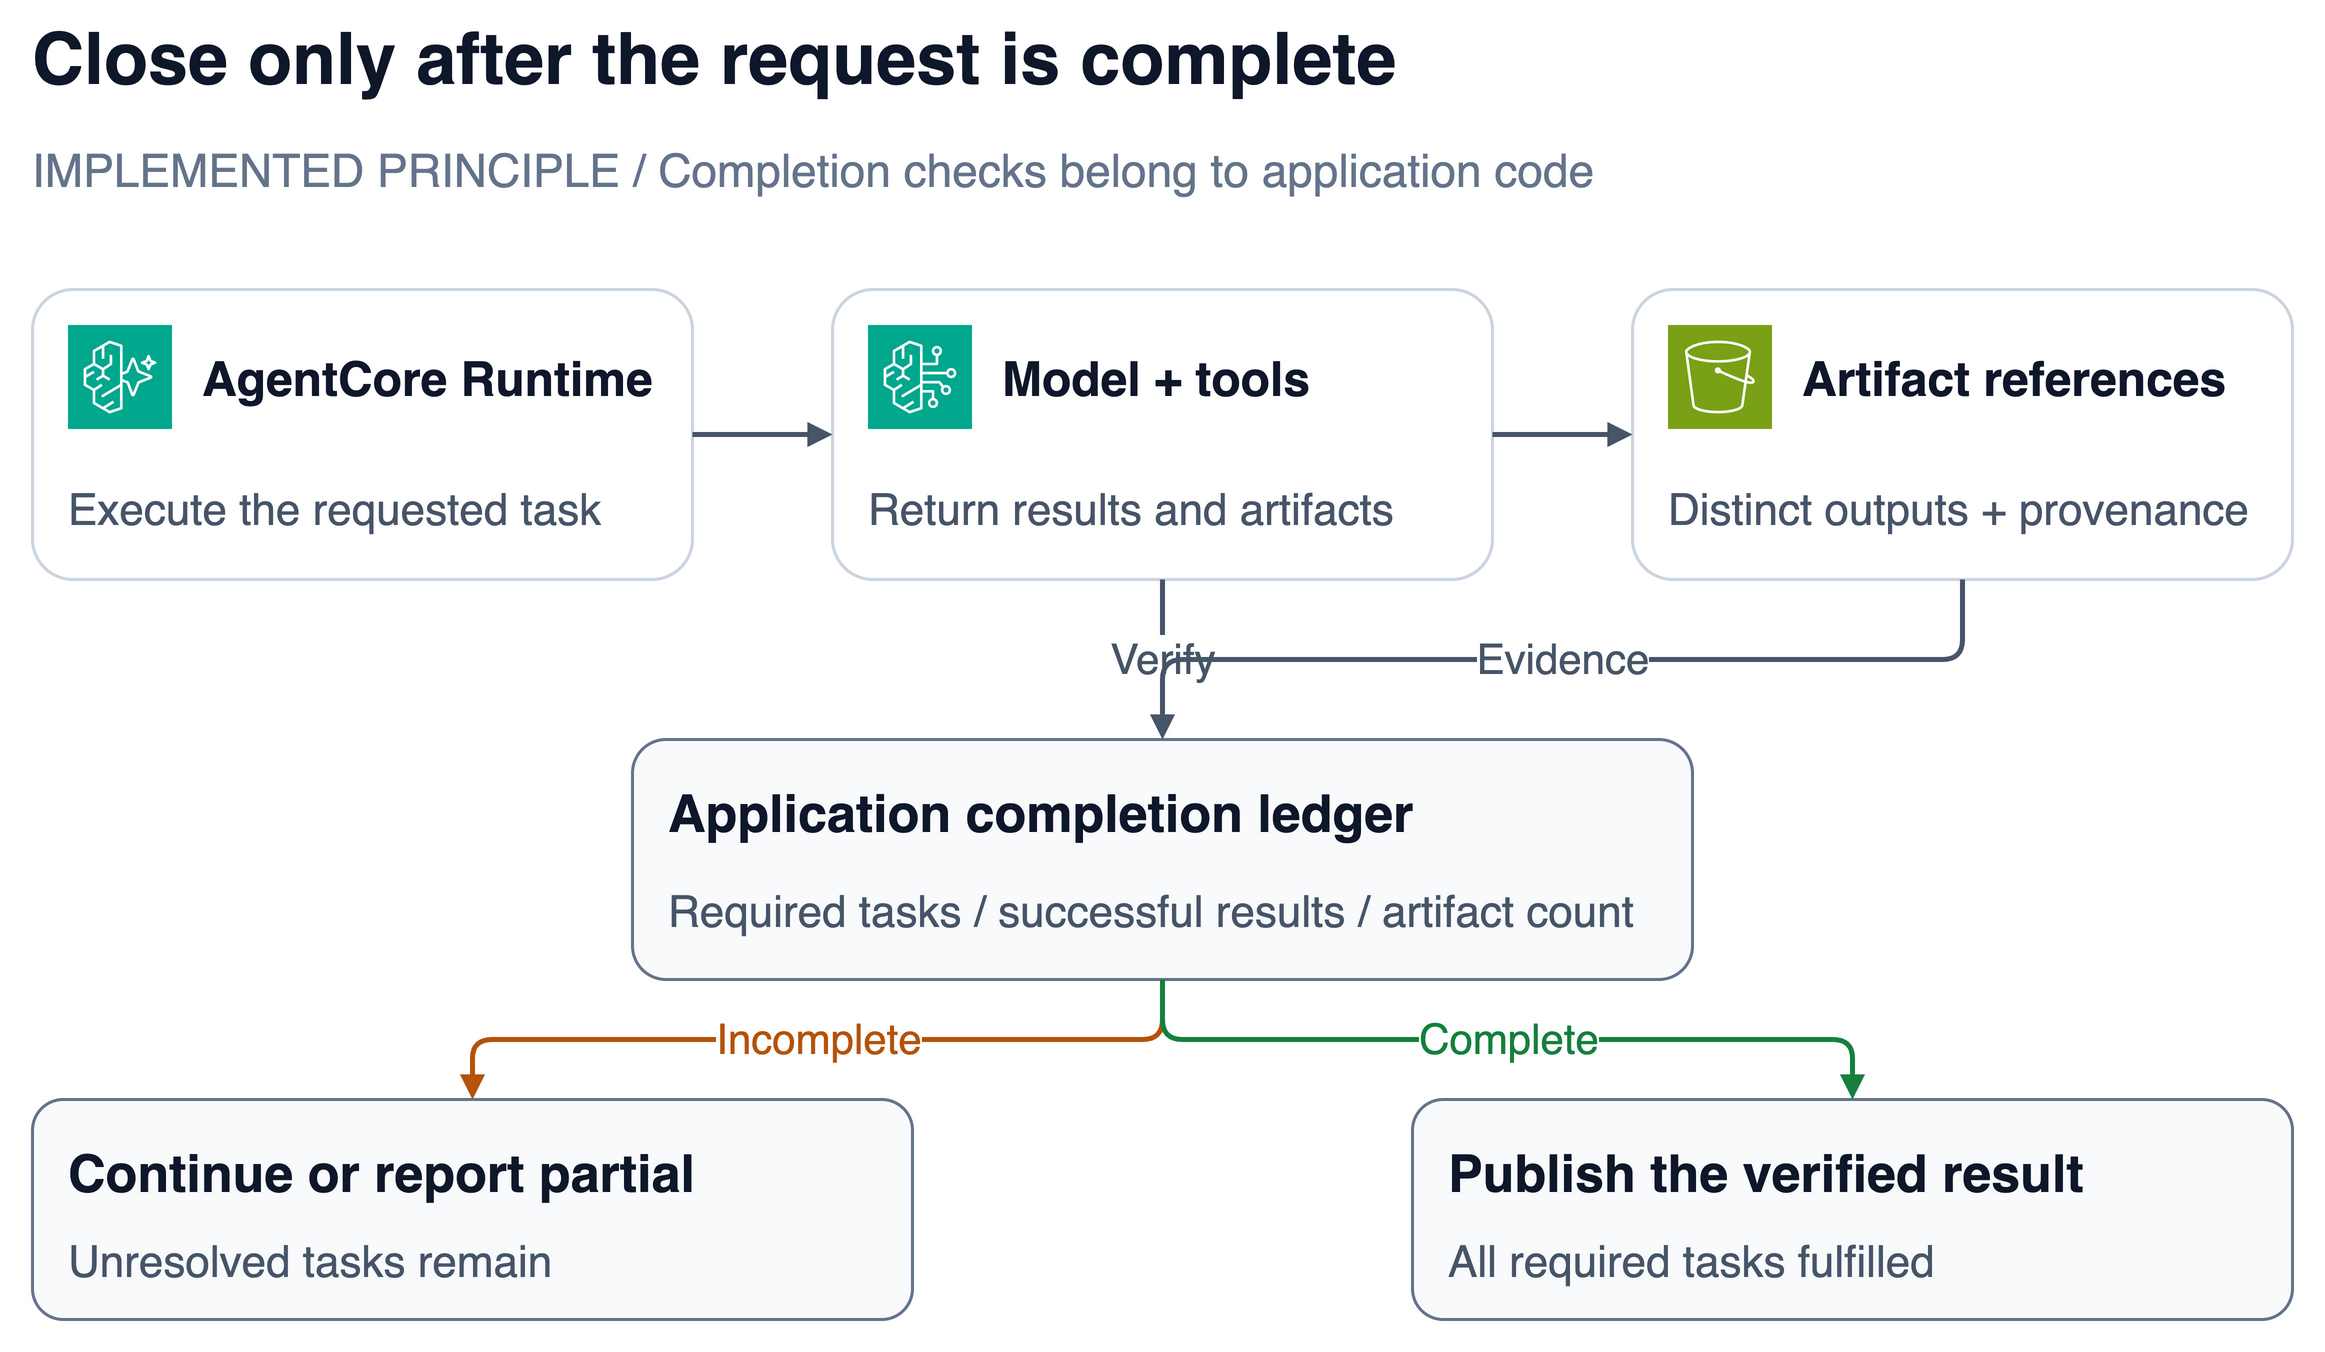
우리 구현은 요청 완료 원장에 검색·첨부 확인·그래프 같은 독립 작업을 기록했다. 모델이 완료했다고 말하는 문장은 실행 증거로 쓰지 않는다. 성공한 도구 결과와 실제 산출물로 각 항목을 확인한다. 그래프 두 개를 요청했다면 서로 다른 산출물 두 개가 필요하다. 같은 이미지의 서명 URL이 갱신됐다고 새 그래프로 세지 않는다.
필요한 결과를 직접 반환한 뒤 남은 작업이 없으면 오케스트레이터의 후속 모델 턴을 종료한다. 내부 기준 검색이나 결과 해석이 남아 있다면 계속 실행한다. 이 조건으로 불필요한 호출을 줄이고 요청 누락을 막는다. 완성된 답변을 다시 서술하면서 숫자나 근거를 바꾸는 위험도 줄인다.
다음은 실제 완료 판단을 단순화한 의사코드다. 그대로 실행하는 SDK 예제가 아니다.
required = parse_required_tasks(request)
results = execute_allowed_tools(required, auth_context)
confirmed = verify_tool_results_and_artifacts(results)
remaining = required - confirmed
if remaining:
    continue_or_report_partial(remaining)
else:
    publish_verified_result_and_close()
모델의 의도 해석은 도구 선택을 돕는다. 권한, 기간, 대상, 산출물 개수와 완료 판정은 코드가 다시 검증한다. 전체 계정 수를 묻는 빠른 조회가 전체 계정 분석을 대신하거나, 첨부한 그래프를 설명해 달라는 요청을 새 그래프 생성으로 바꾸지 않는지도 회귀 사례에 넣는다.
오래 걸리는 분석은 대화 밖에서 끝낸다
AgentCore Runtime은 비동기·장시간 실행을 지원한다. SDK는 작업 시작과 완료를 추적해 세션의 처리 상태를 관리한다.4 짧은 백그라운드 작업에는 이 기능이 충분할 수 있다. 수많은 대상을 순회하고 실패한 구간만 다시 실행하며 브라우저를 닫은 뒤에도 결과를 찾아야 하는 업무는 별도의 작업 상태가 필요하다.
우리 데이터 분석 구현에서는 업무 API가 요청을 접수하고 Step Functions Standard가 ECS Fargate 워커를 실행한다. DynamoDB에는 작업 상태를, S3에는 입력·수집 명세·중간 결과·최종 산출물을 보존한다. 대화형 요청은 AgentCore의 스트리밍 경로로 처리한다. 모든 요청을 하나의 긴 대화 세션에 묶지 않는다.
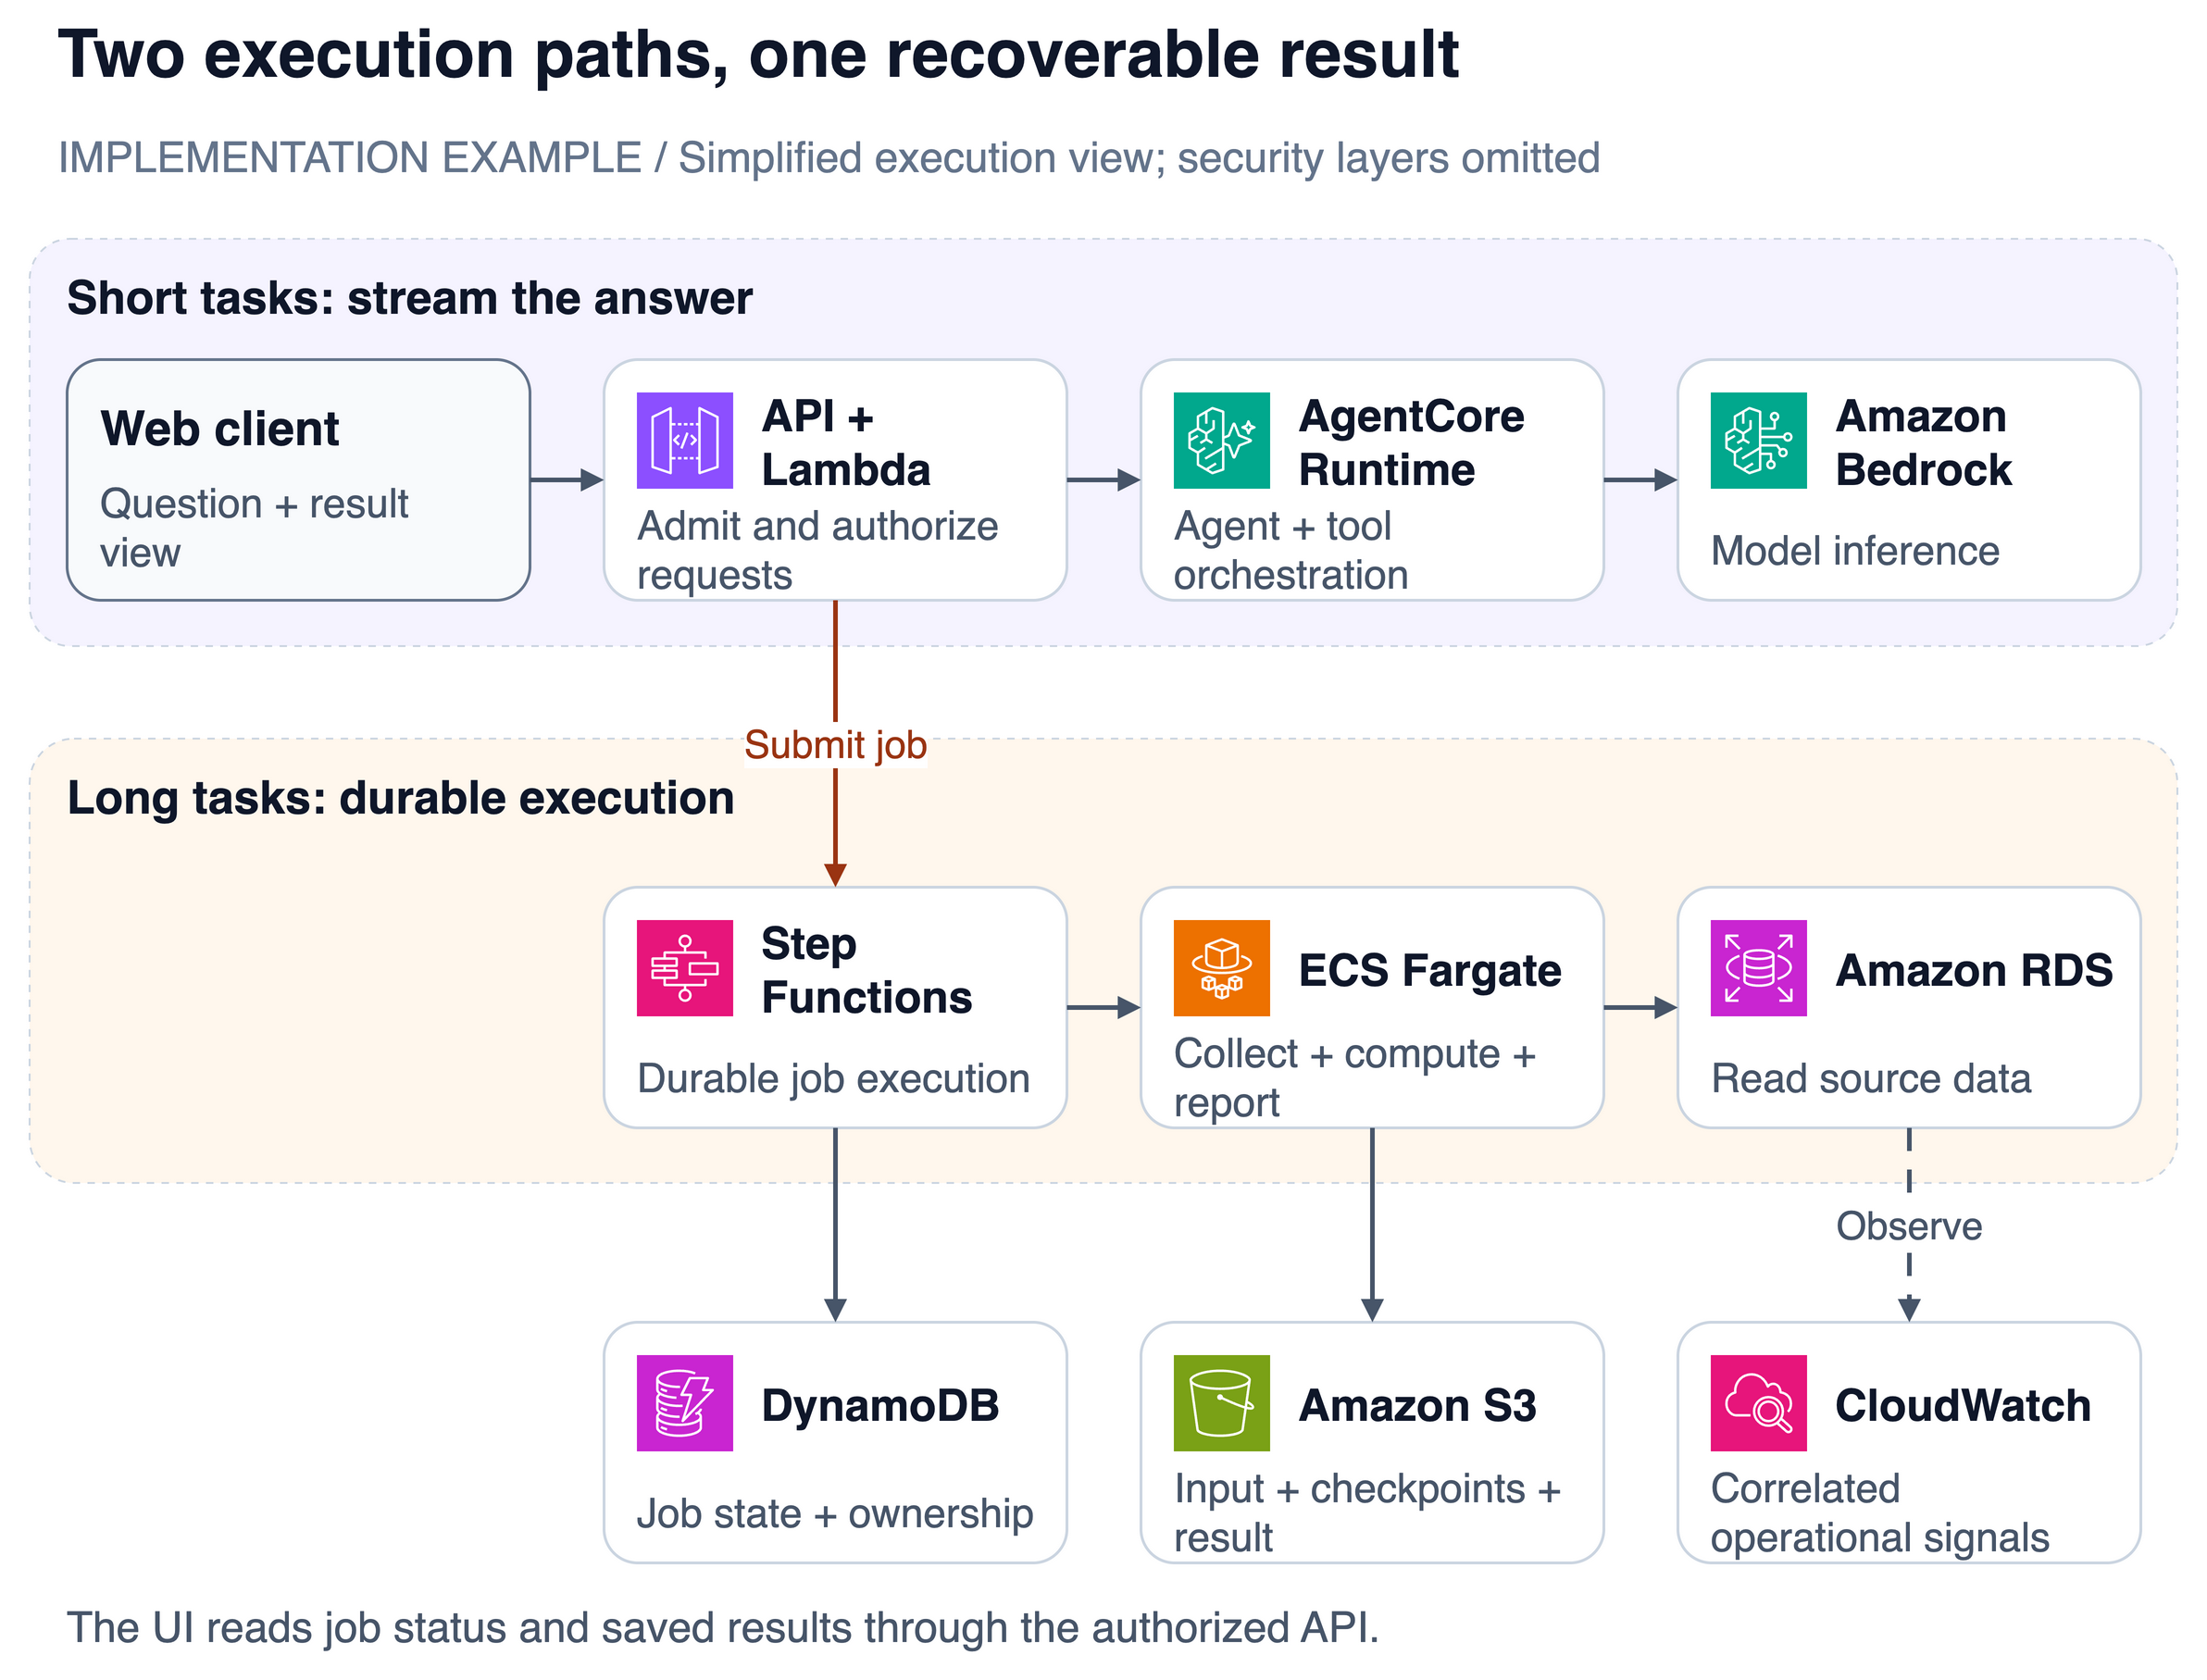
작업에는 소유자와 대화, 시도 번호, 실행 소유권을 결합한다. 워커가 재시작되면 이미 저장한 성공 단위를 재사용한다. 이전 시도의 워커가 늦게 끝나더라도 현재 시도의 결과를 덮어쓰지 못하게 한다. 취소·소유권 확인도 결과 저장과 완료 경계에서 다시 수행한다.
화면에는 QUEUED, RUNNING, COMPLETED, FAILED, CANCELLED를 작업 상태로 제공했다. 조회가 실패한 작업을 데이터 없음으로 표시하지 않고, 재시도와 취소를 명시적인 행동으로 제공한다. 접수한 요청의 분석 조건과 결과를 같은 작업에 묶으므로 사용자가 대화를 다시 열어도 어느 질문의 결과인지 확인할 수 있다.
AgentCore 세션의 격리는 실행 환경을 분리하는 기능이다.5 저장한 작업을 읽을 권한까지 자동으로 판정해 주지는 않는다. 작업 목록·결과·다운로드 API에서 역할과 소유권을 검사하고, Runtime 세션 ID를 사용자 인증 수단으로 쓰지 않는다.
캐시는 프롬프트·중간 결과·화면 결과로 나눈다
캐시를 추가했다는 설명만으로는 무엇이 빨라졌는지 알 수 없다. 우리 구현에는 목적이 다른 캐시가 있었고, 재사용 조건도 달랐다.
| 캐시 | 재사용하는 것 | 확인할 조건 |
|---|---|---|
| Bedrock 프롬프트 캐시 | 반복되는 역할 지침과 도구 정의 | 지원 모델·API, 고정 접두부, 실제 캐시 읽기·쓰기 |
| 분석 중간 결과 캐시 | 성공적으로 저장한 수집·계산 중간 결과 | 작업·수집 명세·체크포인트 버전·소유권 |
| 화면 결과 캐시 | 이미 가져온 완료 작업의 응답 | 대화·작업 ID, 로그인 계정 전환 시 폐기 |
프롬프트는 매번 같은 지침을 앞에, 질문·시각·요청 문맥을 뒤에 배치했다. 고정 구간을 분리하고 캐시 사용 여부를 배포 설정에 묶었다. Bedrock의 캐시 지원과 최소 토큰 수, 유효시간은 모델과 API에 따라 달라지며 설정만으로 적중을 보장하지 않는다. cacheReadInputTokens와 cacheWriteInputTokens 등 해당 API의 사용량 필드를 확인하고, 캐시 쓰기 비용까지 포함해 효과를 판단한다.6
중간 결과는 같은 워커가 S3에 성공적으로 저장한 값을 제한된 로컬 저장소에서도 재사용했다. 로컬 값이 없거나 손상되면 S3에서 복구한다. 로컬 캐시는 최적화이고 내구성의 기준은 저장된 체크포인트다. 프로세스가 사라지면 없어지는 값을 유일한 복구 근거로 삼지 않는다.
화면 캐시는 완료 응답을 반복해서 가져오거나 중복으로 붙이는 일을 줄인다. 같은 대화에서 인증 토큰이 갱신됐다는 이유로 완료 답변을 지우지 않는다. 다른 계정으로 전환하면 사용자별 캐시를 폐기하는 경계를 별도로 검증한다. 질문 문장이 같아도 권한과 데이터 시점이 다르면 같은 결과로 취급할 수 없다.
AgentCore Memory는 이 캐시들과 구분한다. 대화 이벤트와 장기 문맥을 저장·검색하는 기능이며, 사용할 정보를 기록하고 조회해 현재 요청에 연결하는 통합이 필요하다.7 사용자 선호나 이전 대화를 기억해도 최신 원본 수치와 접근 권한은 도구가 확인한다. 기억에 남은 과거 답변을 현재 분석의 증거로 쓰지 않는다.
반복 조회를 줄일 때 실패와 빈 데이터를 구분한다
대규모 분석에서는 값이 없는 기간도 반복해서 조회하고, 계정별 계산 때 같은 묶음의 중간 결과를 다시 읽는 비용이 컸다. 우리는 원본 범위를 먼저 확인하고, 검증된 빈 구간의 반복 조회를 줄였다. 원본 범위 확인이 실패하면 기존 조회를 계속했다. 조회 오류는 빈 데이터로 바꾸지 않았다.
소유권 확인의 원격 왕복도 조절했다. 반복문 안에서는 호출 빈도를 제한하되 실제 원본 읽기와 저장, 진행 갱신, 완료 경계에서는 강제로 확인했다. 확인을 제거하는 방식으로 속도를 높이지 않았다. 취소한 작업의 늦은 결과가 게시되지 않는지를 함께 검사했다.
다음은 2026년 10월 13일 운영에서 같은 질문을 다시 실행한 관측 결과다. 워커 자원은 개선 전후 모두 2 vCPU·8 GiB였다.8
| 분석 범위 | 개선 전 요청 → 답변 게시 | 개선 후 | 관측 단축률 |
|---|---|---|---|
| 271일 범위 | 9분 38.3초 | 8분 25.8초 | 12.5% |
| 643일 범위 | 18분 43.2초 | 14분 22.1초 | 23.2% |
중간 결과 읽기·계정 계산은 각각 89초에서 20초, 198초에서 49초로 줄었다. 이후에도 원본 수집 구간이 각각 437초와 750초로 가장 오래 걸렸다. 압축 해제와 표본 변환의 일부 누적 시간은 오히려 늘었다. 전체 시간이 줄었다고 모든 단계가 개선됐다고 설명할 수는 없다.
측정 중 활성 대상과 원본 데이터가 바뀌었으므로 통제된 A/B 실험이나 p95·SLA 결과는 아니다. 271일 범위도 한 해 전체를 측정한 값이 아니다. 긴 범위의 화면 최초 완료 시간은 인증 중단으로 비교에서 제외했다. 다시 로그인해 결과를 열어 본 기록은 결과 보존의 증거로만 사용했다.
비교 가능한 기존 대상의 결과를 대조하고, 수치가 달라진 대상은 뒤늦게 들어온 표본과 별도로 확인했다. 개선 전후 출력의 일치 검사는 독립적으로 모든 원본을 다시 계산한 검증과 다르다. 다음 개선은 원본 수집의 CPU 시간·네트워크 대기·변환 비용을 나눠 측정하는 일이다.
사용자는 실행 상태를 보고 다음 행동을 결정한다
사용자는 에이전트 내부의 도구 호출보다 현재 작업이 무엇을 하고 있는지 알고 싶어 한다. 화면에서는 준비, 수집, 계산, 결과 정리의 작업 단계와 완료 단위·전체 단위·조회 실패를 표시했다. 수집이 끝났다는 사실과 전체 보고서가 완성됐다는 사실을 구분한다. 정확한 예상 시간을 측정하지 않았다면 임의의 남은 시간을 보여주지 않는다.
서버가 완료한 분석의 진행 카드가 멈춘 문제에서는 상태 조회와 인증 갱신의 연결을 고쳤다. 401·403은 로그인 상태 확인으로, 404는 대화 없음으로 구분했다. 새 토큰이 들어오면 조회를 재개하고 이미 가져온 완료 답변은 유지했다. 대화를 바꾼 뒤 늦게 도착한 응답이 새 대화에 들어가지 않도록 현재 대화도 확인한다.
이 변경은 데스크톱·모바일의 합성 인증 시험에서 조회 재개·답변 보존·중복 결과 요청 방지를 확인했다. 운영 사용자의 실제 만료를 다시 일으킨 시험과는 구분한다. 실패 표시를 없애는 것이 개선 목표가 아니다. 사용자가 로그인 확인, 다시 열기, 재시도 중 필요한 행동을 선택할 수 있어야 한다.
| 상황 | 사용자가 확인할 내용 | 이어갈 행동 |
|---|---|---|
| 접수 완료 | 요청 조건과 작업 식별 정보 | 다른 작업을 하다가 다시 연다 |
| 처리 중 | 현재 단계와 확인한 단위 | 기다리거나 취소한다 |
| 일부 조회 실패 | 실패한 범위와 완료 여부 | 같은 조건으로 실패 범위를 다시 실행한다 |
| 인증 갱신 필요 | 작업 상태와 화면 연결 상태의 차이 | 인증을 확인하고 저장된 작업을 다시 연다 |
| 완료 | 원래 질문, 결과, 적용 조건과 근거 | 후속 질문 또는 결과 다운로드를 진행한다 |
후속 질문이 분석 조건을 설명하는 요청인지 새 계산을 원하는 요청인지도 구분한다. 기존 분석이 어떤 기간을 사용했는지 물었을 때 저장된 명세로 답하면 충분하다. 불필요한 재계산은 지연과 비용을 늘리고, 변한 원본 때문에 이전 답변과 다른 수치를 만들기도 한다.
연구 문서로 확장하면 승인과 재개를 별도로 설계한다
앞의 원칙을 연구계획서와 성능평가 보고서에 적용하면 완료의 의미가 더 넓어진다. 문장이 생성됐다는 사실만으로 제출할 수는 없다. 원본 근거, 계산 결과, 규칙 검증, 검토 의견과 사람의 결정을 함께 확인해야 한다. 다음은 제안서와 구현명세서에 정리한 설계이며 운영 성과로 제시하지 않는다.
역할은 작성, 검증, 제출 가능 여부를 정리하는 가승인으로 분리한다. 가승인은 사람이 내리는 공식 승인과 다른 상태다. 모델을 여러 개 썼다는 사실만으로 검증이 독립적이라고 보지도 않는다. 수치·단위·분모는 검토한 계산 도구로 확인하고 생성 모델은 그 결과와 근거를 문서에 연결한다.
검색은 접근 가능한 문서 버전과 원문 위치를 반환한다. 검토자가 인용을 선택하면 실제 원문 구간을 볼 수 있어야 한다. 원본이 개정되면 기존 승인본을 덮어쓰지 않고 새 문서 버전과 재검토를 만든다. 관계 검색과 RAG를 확장할 때도 이 근거 계약을 유지한다. 검색 품질을 별도로 평가하는 방법은 RAG 품질 회귀 평가에 정리했다.
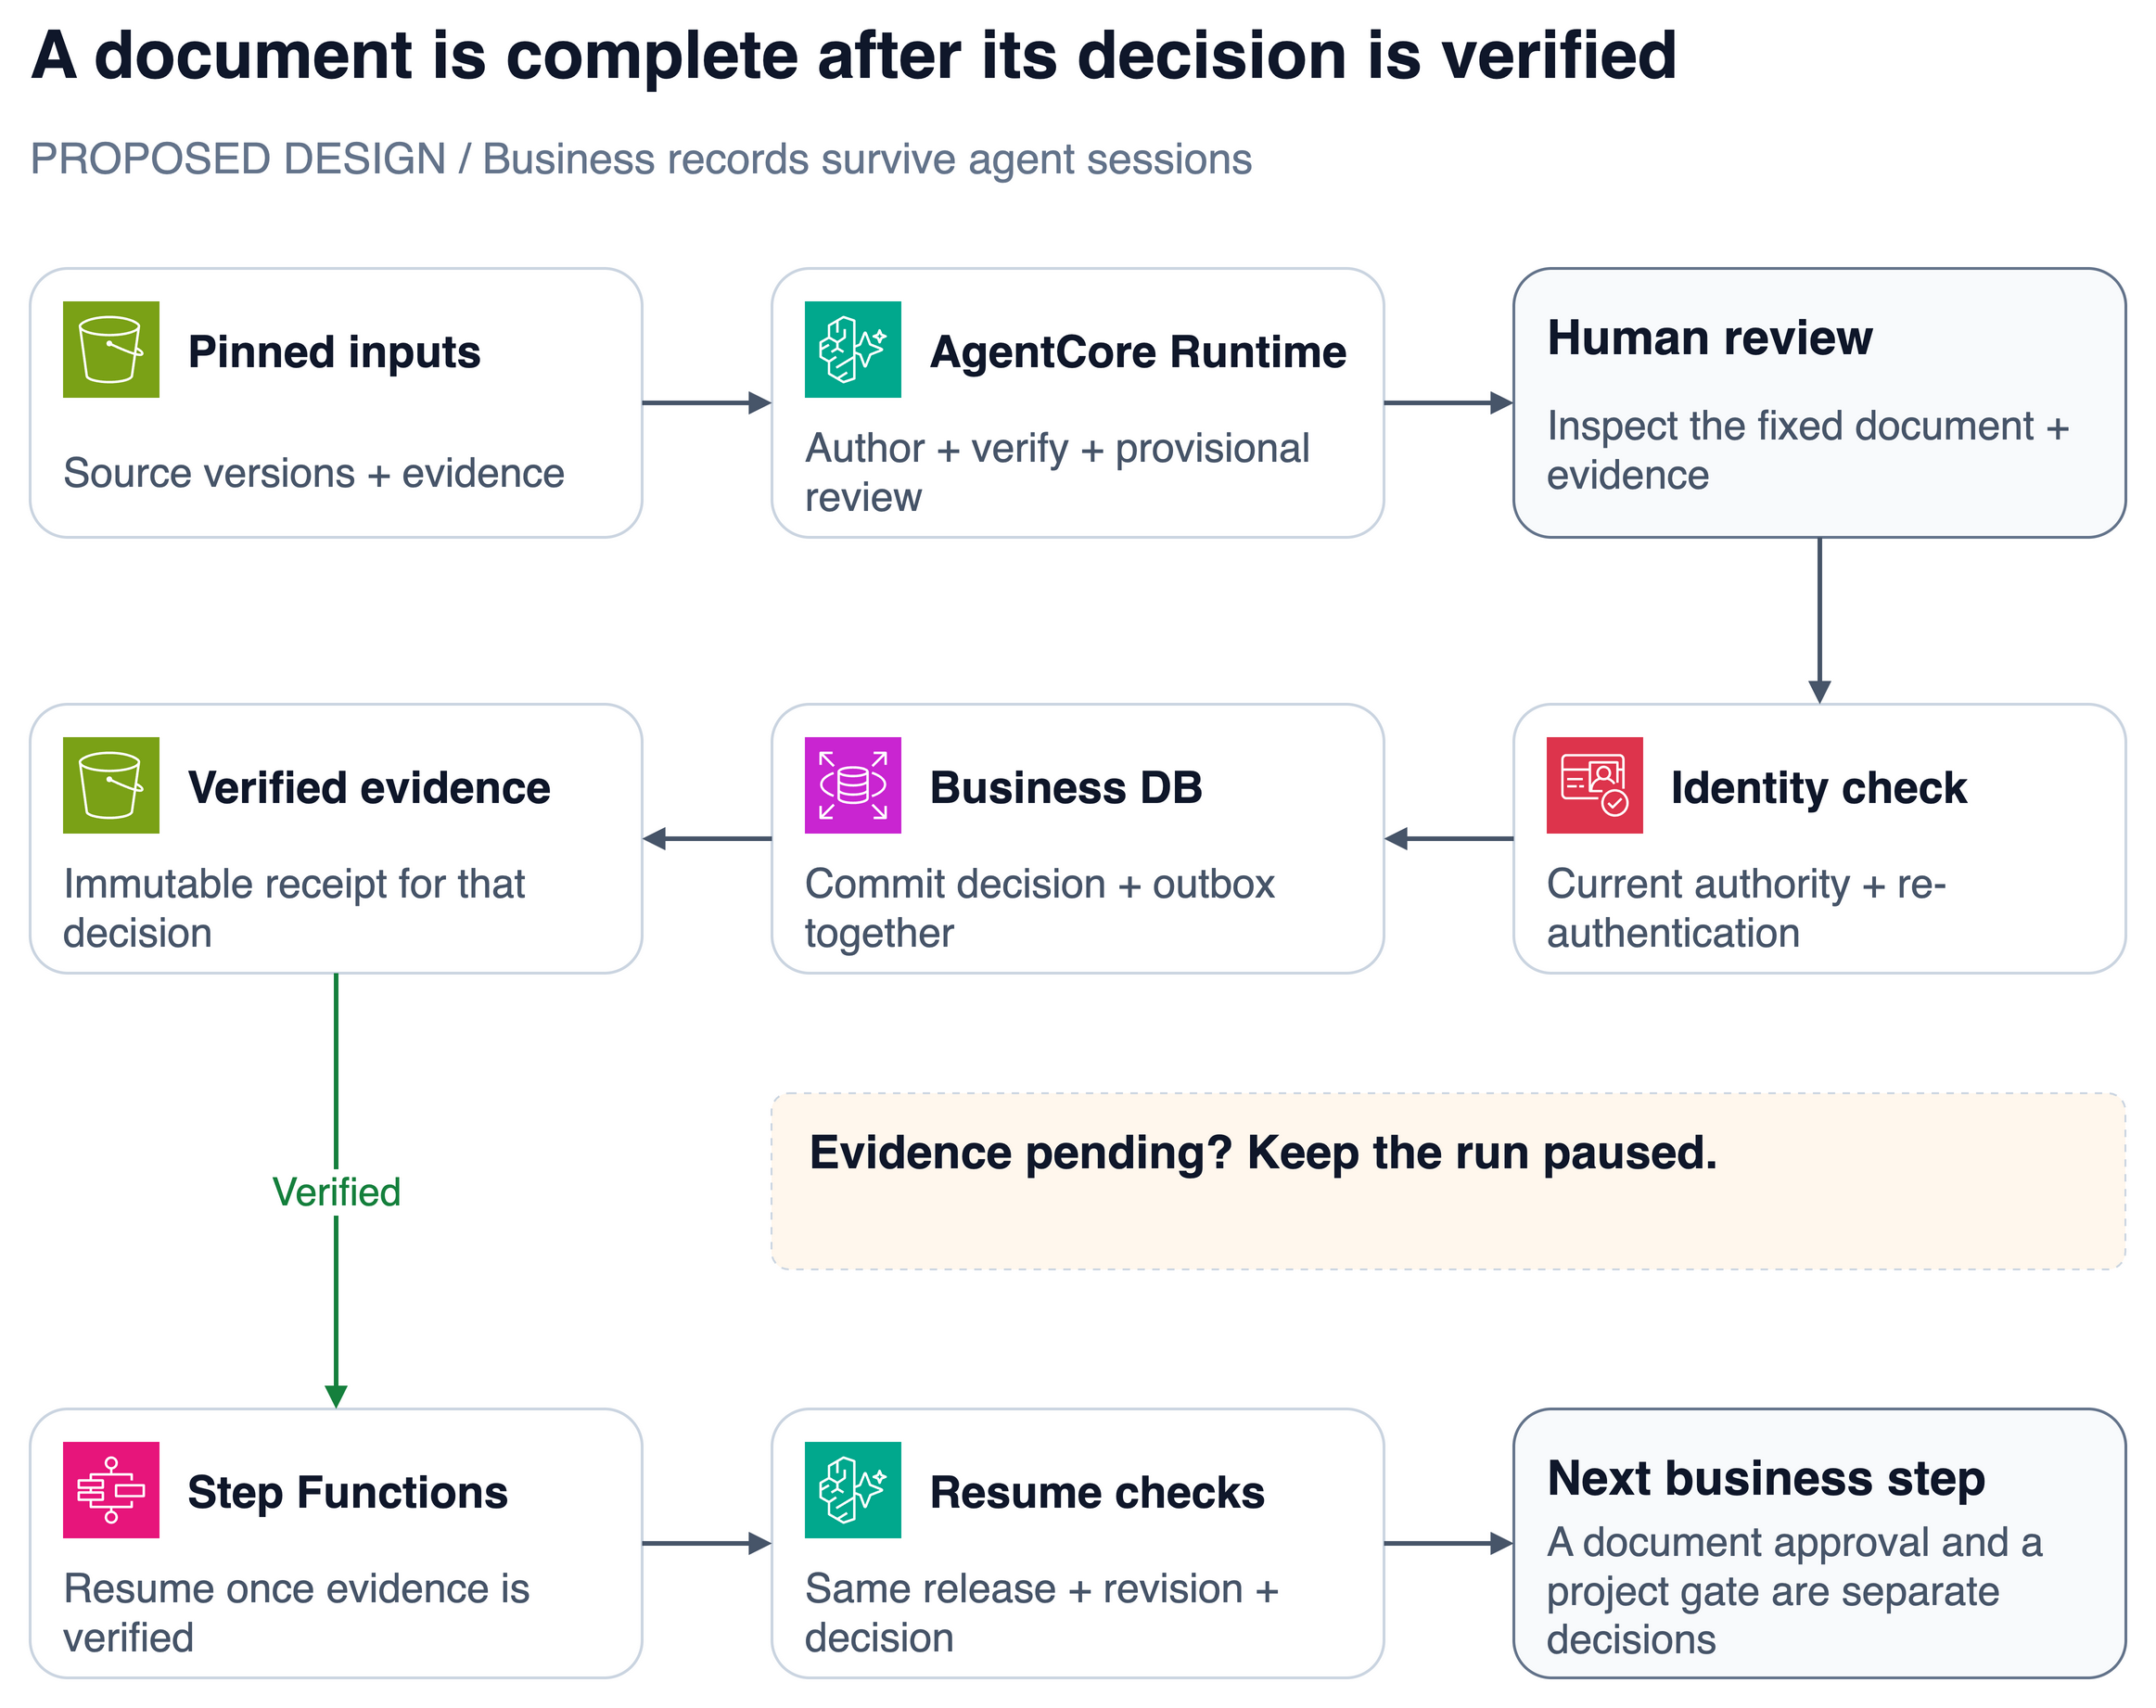
승인 요청에는 문서 버전·해시·근거 묶음·정책·승인권자를 고정한다. 검토 확인 문항은 독립 담당자가 기준답과 근거를 검토한 뒤 사용한다. 문항을 통과했다는 사실만으로 승인하거나 이해도를 완전히 입증했다고 보지 않는다. 현재 권한과 요청에 결합된 재인증을 확인한 사람이 명시적으로 결정한다. 반려는 정답 통과를 요구하지 않고 사유와 권한을 확인해 처리한다.
장기 대기는 Runtime의 메모리 밖에 보존한다. Strands의 중단·재개와 세션 저장은 실행을 이어가는 기반이지만 회사의 승인 원장은 애플리케이션이 관리한다.9 Step Functions의 콜백 대기도 재개 연결 수단이다.10 도구가 다시 실행될 때 확정 결정과 현재 문서·권한을 검사한다. 필수 승인 도구에는 한 번 승인하면 계속 허용하는 우회 정책을 적용하지 않는다.
증적 저장과 결정 확정의 순서도 설계했다. 준비 패키지를 S3에 저장한 단계는 최종 승인이 아니다. 업무 DB에 결정과 전달할 사건을 함께 확정한 뒤, 그 결정을 참조하는 불변 증적을 저장·검증한다. 증적이 아직 확인되지 않았다면 committed와 evidence_state=pending을 보여주고 승인 완료 표시와 재개를 보류한다. 저장 재시도는 같은 결정으로 이어가며 새 승인을 만들지 않는다.
이 설계에서 문서 직접 수정과 스킬 개선도 구분한다. 사람이 생성 결과를 고친 사례는 문서 보완이다. 스킬 개선의 효과는 같은 입력·근거·배포 구성을 고정하고 개정한 스킬로 다시 생성한 결과에서 측정한다. 승인 책임과 재현 가능한 근거를 유지하면서 수정 부담이 줄었는지 확인한다.
모델보다 큰 단위로 버전을 고정하고 평가한다
모델 ID만 기록하면 같은 실행을 다시 설명하기 어렵다. 프롬프트·도구·스킬·규칙·양식·검색 설정이 바뀌면 같은 모델에서도 결과가 달라진다. 우리 코드에서는 모델과 추론 옵션, 프롬프트 구성과 해시, 코드 버전을 실행 추적에 연결했다. 연구 문서 설계는 이 원칙을 배포 묶음으로 확장했다.
다음은 제안의 버전 고정 원칙을 설명하는 JSON 설계 예시다. 값은 가상 식별자이며 AWS API의 요청 스키마나 실행 결과가 아니다.
{
  "status": "design-example",
  "release_bundle": "release-example",
  "versions": {
    "model": "model-version",
    "prompt": "prompt-version",
    "skill": "skill-version",
    "rules": "rules-version",
    "template": "template-version",
    "retrieval": "retrieval-version"
  },
  "evaluation": "evaluation-for-this-bundle",
  "activation": "owner-review-required"
}
진행 중 실행은 시작 당시의 묶음을 유지한다. 변경 후보는 같은 입력으로 기준 버전과 비교하고 승인한 묶음만 새 실행에 적용한다. 복구할 때도 프롬프트만 바꾸는 대신 검증한 이전 조합으로 돌아간다. 코드·Runtime·워커·화면의 배포 버전이 실제로 맞는지도 확인한다.
평가는 정상 질문 외에 복합 요청·데이터 없음·조회 실패·권한 밖 요청·취소·인증 갱신·중복 전달을 포함한다. 연구 문서에는 근거 상충·분모 불일치·문서 개정·권한 회수·증적 지연·오래된 승인 요청의 재개를 추가한다. 모델이 채점한 평균 하나로 수치 정확성이나 승인 여부를 결정하지 않는다.
역할별 모델과 추론 옵션도 같은 평가에서 비교한다. 의도 해석과 긴 문서 작성이 같은 추론 예산을 요구하지는 않는다. 작은 모델이나 낮은 추론 수준이 충분한 역할은 관측 결과로 선택하되 실패한 분류가 권한·계산 경계를 바꾸지 못하게 한다. 구체적인 비교 절차는 모델·프롬프트 선정 평가를 참고할 수 있다.
우리 시스템에는 어떤 개선부터 적용할까
먼저 가장 자주 실패하거나 오래 기다리는 실제 과업을 고른다. 그 요청을 접수·추론·도구·저장·화면의 시간으로 나누고, 완료를 인정할 결과와 근거를 적는다. 중간 계산을 생략하거나 검사를 줄이기 전에 무엇을 반복해서 수행하는지 확인한다.
| 현재 증상 | 먼저 확인할 것 | 변경 후 확인할 증거 |
|---|---|---|
| 산출물 뒤에도 응답이 이어진다 | 남은 작업과 불필요한 모델 턴 | 복합 요청 누락 없이 종료한다 |
| 긴 작업을 다시 시작한다 | 외부 작업 상태·성공 체크포인트 | 재접속·워커 재시작 뒤 결과를 복원한다 |
| 반복 질문이 계속 느리다 | 고정 프롬프트와 중간 결과 재읽기 | 실제 캐시 읽기, 권한·데이터 버전 유지 |
| 진행 카드가 멈춘다 | 인증 갱신·상태 조회·대화 전환 | 조회 재개, 기존 답변 보존, 중복 방지 |
| 빠르지만 결과를 신뢰하기 어렵다 | 대상·기간·근거·계산·완료 계약 | 원본 대조와 실패·빈 데이터 구분 |
| 문서 검토가 반복된다 | 근거 위치·고정 문서·스킬 평가 | 같은 입력의 재생성 비교와 건별 결정 |
대표 과업의 전후 결과와 회귀 사례를 먼저 확보한다. 그다음 반복 측정과 동시 부하, 요청당 비용, 복구 시간을 넓혀 확인한다. 일반적인 운영 전환의 책임과 출시 기준은 AI PoC 운영 전환 게이트와 연결해 검토하면 된다.
AgentCore 위에서 좋은 에이전트를 운영하려면 빠른 답변과 확인 가능한 완료를 함께 설계해야 한다. 필요한 결과가 준비되면 끝내고, 오래 걸리는 일은 다시 열 수 있게 남기며, 검토가 필요한 결정은 근거와 책임자를 연결한다. 이 경계가 분명할수록 모델·캐시·도구를 바꾼 효과도 정확히 측정할 수 있다.
실제 요청의 지연 구간과 작업 복구, 평가·배포 기준을 함께 점검하려면 클라우드 & 인프라와 데이터 & ML 엔지니어링에서 적용 범위를 확인할 수 있다.
참고 자료
제품 동작과 공식 문서는 2026년 10월 14일 확인했다. 구현 관측과 설계 제안의 근거 수준은 본문에서 구분했다.
출처와 각주10개펼치기접기
Footnotes
-
AWS, Host agent or tools with Amazon Bedrock AgentCore Runtime. 실행 기반과 서비스 기능을 확인했다. ↩
-
801플래닛 내부 구현 코드와 연구 문서 에이전트 제안서·상세 구현명세서, 2026년 10월 14일 검토. 고객명·계정·리소스·원본 화면·내부 링크는 공개하지 않았다. 연구 문서 예제는 제안·설계이며 운영 구현·검증 결과가 아니다. ↩
-
AWS, Observe your agent applications on Amazon Bedrock AgentCore Observability. ↩
-
AWS, Handle asynchronous and long running agents with Amazon Bedrock AgentCore Runtime. SDK 작업 추적과 세션 처리 상태를 설명한다. ↩
-
AWS, Prompt caching for faster model inference. 지원 모델·API와 적중·사용량 조건은 변경될 수 있다. ↩
-
801플래닛 내부 운영 재측정 기록, 2026년 10월 13일. 같은 질문과 범위, 동일 워커 자원으로 비교했으나 대상 집단·원본 데이터·네트워크·동시 부하를 통제한 반복 실험은 아니다. ↩
-
Strands Agents, Interrupts, Human in the loop. ↩
-
AWS, Discover service integration patterns in Step Functions. ↩